1. 聚簇索引, 和 非聚簇索引
聚簇索引是由每张表的主键来建立的, 而非聚簇索引是按照非组件列来建立的。
在innodb中没张表只有一个聚簇索引, 而可以有多改非聚簇索引。
聚簇索引的叶子节点存储的是整行的数据, 而非聚簇索引叶子节点储存的是主键的值和对应行的指针
2. 聚簇索引是怎么构建的
在mysql中, 当你指定了表的主键时, mysql会自动为该主键创建聚簇索引。如果没有指定主键,则会自动为第一个非空唯一索引创建聚簇索引。如果没有这样的索引, mysql会自动为innodb表创建一个cen_clust_index的隐藏的聚簇索引。
3. 回表索引和索引覆盖
回表指的是, mysql使用非聚簇索引查询时, 需要用到主键索引中查询数据行的过程。如果查询语句需要返回的列都在非聚簇索引中, 那么就可以避免会表查询。
索引覆盖指的是, mysql只需要扫描非聚簇索引而不需要通过主键索引查询数据, 就可以返回查询的数据的过程。
4. 最左前缀匹配规则
当musql使用联合索引的时候, 当查询条件从联合索引的最左边开始匹配时, 才能使用联合索引。例如(abc)联合索引, 使用a=1可以使用联合索引, 使用b=1则无法使用。
5. mysql事务acid
一致性
原子性
隔离性
持续性
原子性:通过relog 和unlog来保证事务的原子性。relog巨鹿修改过的数据, unlog记录了所有被修改国的数据原始值。
一致性:通过锁的机制来实现, 当执行某个事务的时候, mysql会给该数据加锁,其他事务无法修改该数据, 直到事务提交或回滚。
隔离性:通过锁的机制来实现, 与一致性一样。
持续性:使用relog和unlog来保证事务的持久性。
6. mysql四大隔离级别
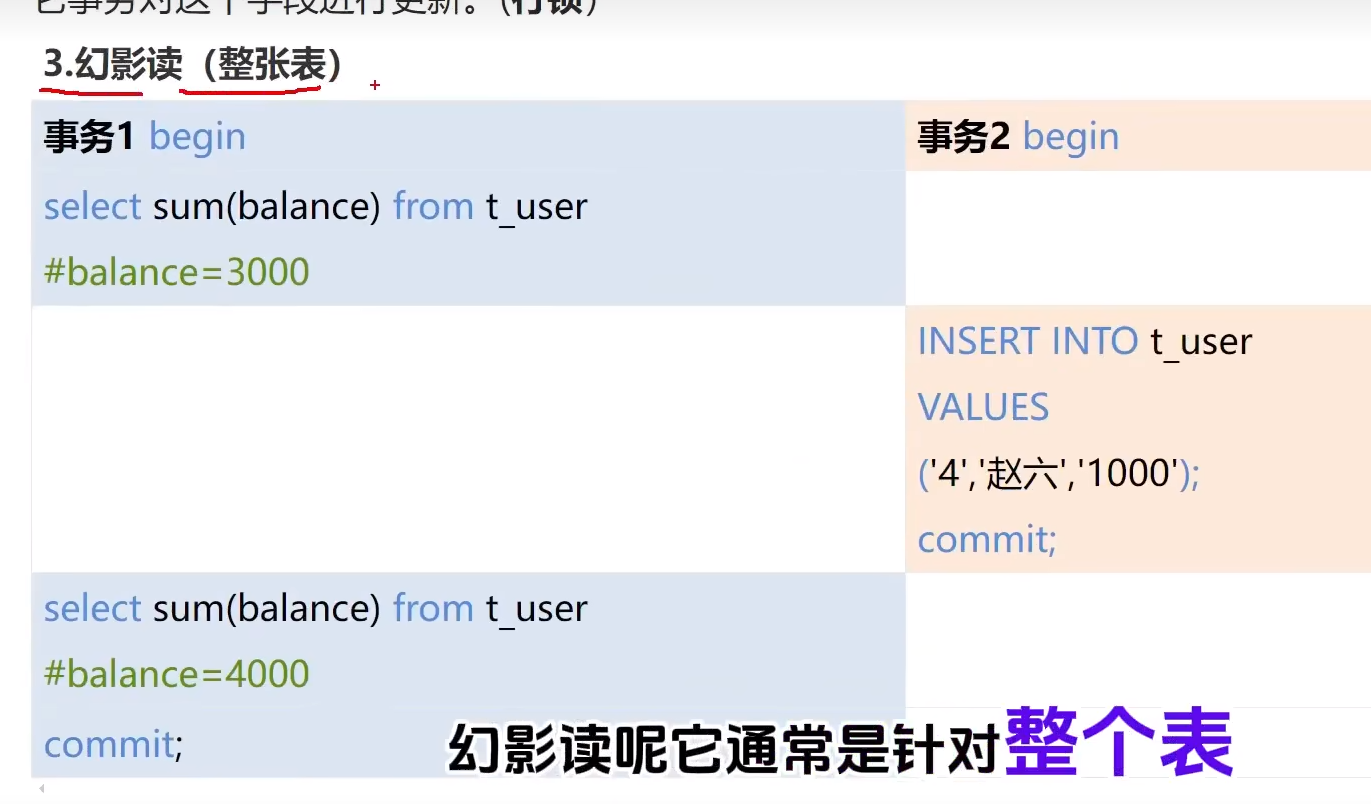
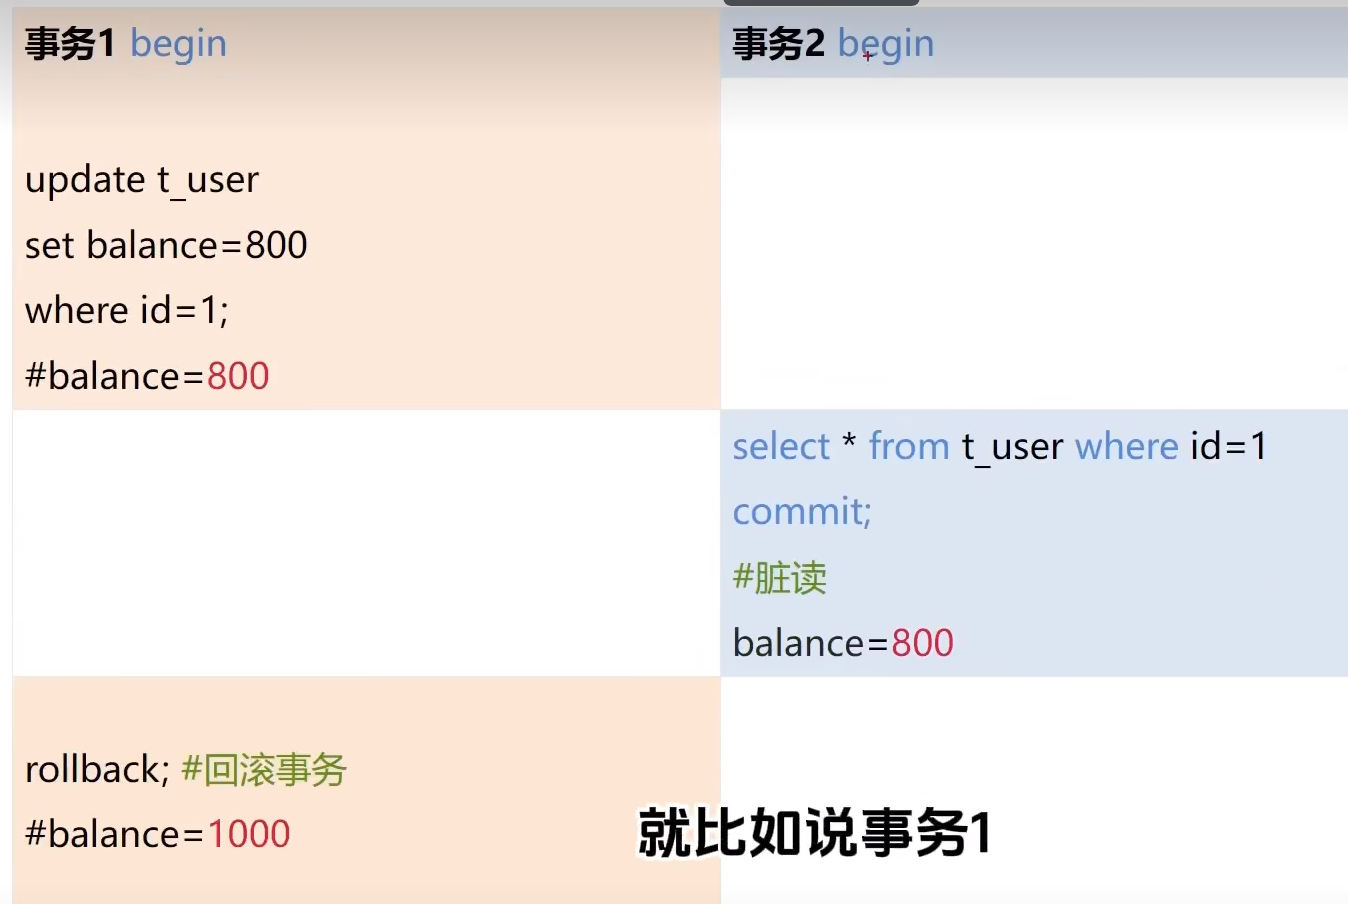
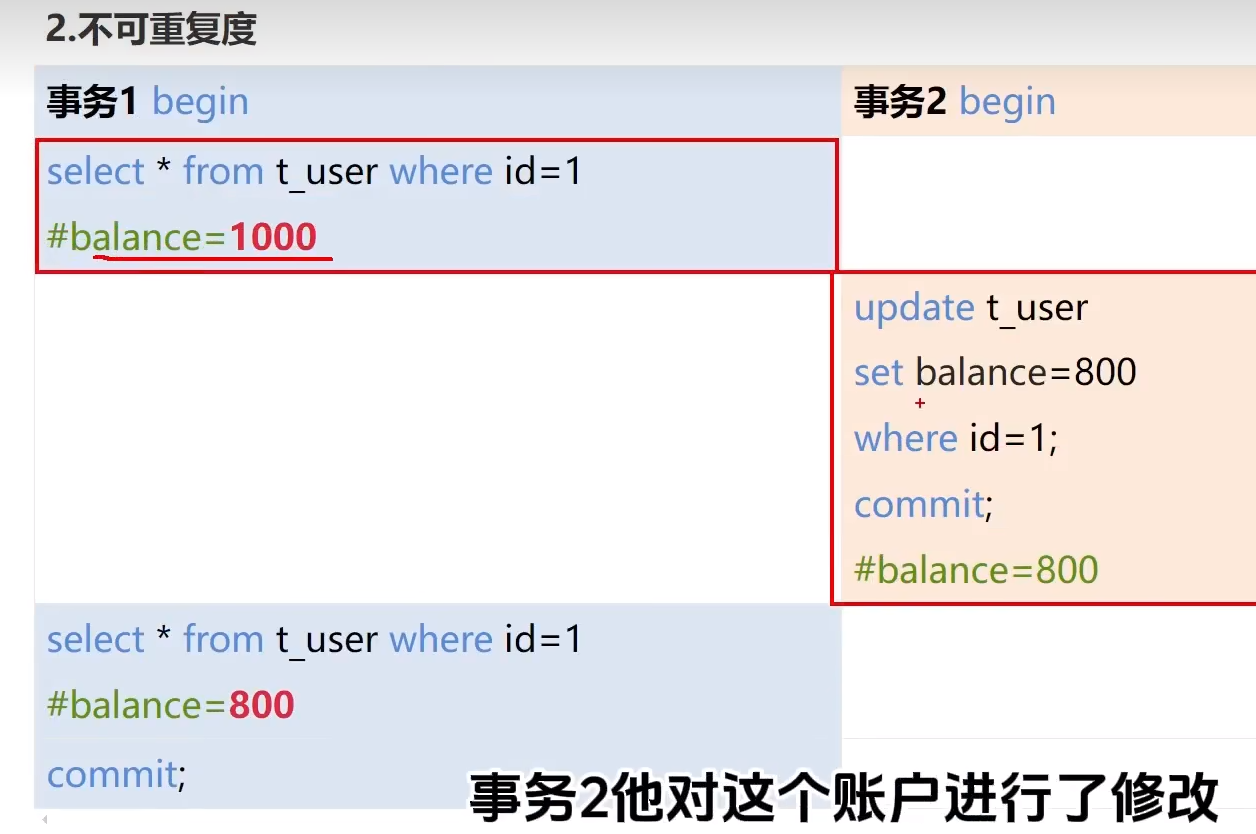
脏读: 没有提交前, 修改的数据被其他事务看到 不可重复度:一次事务中, 两次查询的结果不同 幻读:
度未提交:一个事务可以读取另一个事务未被提交的数据。这在隔离级别可能会导致脏读, 不可重复度和幻读的问题
度已提交:一个事务只能读取另一个事务已经提交的数据。这个隔离级别可以避免脏度,但可能会出现不可重复度, 和幻度的问题。
可重复度:一个事务在执行期间多次读取同一行数据时, 能保证所读取的数据是一致的。这种隔离级别可以避免脏度和不可重复度的问题, 但是会出现幻度问题。
序列化:最高隔离级别, 它通过强制事务性串行来避免脏度, 不可重复度, 幻度的问题。这种隔离级别会影响并发性能,因为会导致大量的锁竞争。
7. B树和B+树的区别
内部结构:B树的节点包含键值和指向子节点的指针,而B+树的节点只包含键值,所有的数据都存储在叶子节点中。

叶子节点:在B树中,所有的叶子节点都包含了指向数据的指针,而在B+树中,叶子节点只包含了数据本身。

搜索:在B树中,搜索可以在非叶子节点结束,因为非叶子节点也包含了指向子树的指针。而在B+树中,搜索必须到达叶子节点才能找到数据。

范围查询:B树可以支持范围查询,因为每个非叶子节点都包含了指向子树的指针。而在B+树中,只有叶子节点包含数据,因此范围查询必须在叶子节点上进行。

遍历性能:由于B树节点包含指向子节点的指针,因此在遍历整个树时需要进行更多的磁盘访问。而B+树的叶子节点是通过链表连接的,因此遍历性能更高。

数据插入和删除:由于B树节点包含指向子节点的指针,因此在插入或删除数据时需要进行更多的指针操作。而B+树只需要修改叶子节点中的指针,因此插入和删除性能更高。

总之,B+树比B树更适合用于数据库索引,因为它可以提供更好的范围查询和遍历性能,并且在数据插入和删除时具有更高的性能。但是,在某些特定的情况下,B树可能比B+树更适合,例如在需要频繁地进行范围查询和单条记录查询的场景中。
8. InnoDB(聚集)索引与mysam(非聚集)索引区别
存储结构:InnoDB使用聚集索引(clustered index),将数据按照主键的顺序存储在磁盘上。而MyISAM使用非聚集索引(non-clustered index),将索引和数据分开存储。

索引结构:InnoDB的索引结构是B+树,支持范围查询和排序等操作。MyISAM的索引结构是B树,不支持范围查询,只能进行等值查询。

读写性能:InnoDB对于读操作和多并发写操作有较好的性能表现,特别适用于高并发的应用场景。MyISAM在读操作上具有较好的性能,但在写操作上会出现锁定整个表的情况,影响并发性能。

容灾性:InnoDB具备事务支持和崩溃恢复的能力,通过日志文件(redo log)来确保数据的一致性。MyISAM不支持事务,且容易发生数据损坏。

锁定粒度:InnoDB采用行级锁定(row-level locking),可以避免数据冲突和锁定竞争。MyISAM采用表级锁定(table-level locking),在并发操作时会产生较大的锁定开销。

空间占用:InnoDB相对于MyISAM,需要更多的存储空间来维护索引和事务日志等结构,因此在相同的数据量下,InnoDB的存储空间消耗通常会更大。

总的来说,InnoDB索引适用于需要事务支持、并发写入和高容灾性的场景,而MyISAM索引适用于读操作较多、对并发写入要求不高的场景。在选择索引类型时,需要根据具体的应用需求和特点进行权衡和选择。另外,MySQL 5.5版本之后,InnoDB成为默认的存储引擎,推荐在大多数情况下使用InnoDB引擎。
9. mysql自增主键与字符串主键区别
数据类型:自增主键通常使用整型数据类型,如INT或BIGINT;而字符串主键则通常使用CHAR或VARCHAR等字符串类型。

数据长度:字符串主键的长度可以根据需要进行设置,而自增主键的长度受限于所选数据类型的范围。

唯一性:无论是自增主键还是字符串主键,都必须具备唯一性,以保证能够有效地识别和访问每个记录。但由于字符串主键的唯一性可能受到大小写、字符集等因素的影响,因此需要特别注意唯一性的约束条件。

查询效率:自增主键可以通过二分查找等高效算法快速定位记录,因为它们的值是连续的数字,而字符串主键需要进行字符串比较,查询效率相对较低。

插入效率:在插入新记录时,自增主键只需要递增计数器即可,不需要进行任何复杂的操作,因此插入速度很快。而字符串主键可能需要进行哈希计算等复杂操作,插入速度相对较慢。

总的来说,自增主键具有较高的查询效率和插入效率,更加适合在大规模数据中使用。而字符串主键则具有更好的人类可读性和易于理解的特点,更适合在小型应用场景或者需要个性化标识的场景中使用,需要根据具体需求进行选择。不过需要注意的是,无论采用哪种类型的主键,都需要遵循主键的基本原则,即唯一性、简洁性和稳定性。
10 MySQL中常见的索引
B-Tree索引:B-Tree(平衡树)索引是MySQL默认的索引类型,适用于大多数应用场景。它使用B+树结构存储数据,支持快速的查找、范围查询和排序操作。

哈希索引:哈希索引基于哈希表实现,适用于等值查询,但不支持范围查询和排序操作。哈希索引对字段进行哈希计算,并将其映射到哈希表中,因此查询速度非常快。但它对于索引列的数据分布敏感,当数据分布不均匀时,可能导致哈希碰撞,降低查询效率。

全文索引:全文索引主要用于在文本内容中进行全文搜索,例如文章的标题和正文。它能够快速匹配关键词,并返回相关的结果。MySQL提供了全文索引的支持,但只能用于InnoDB存储引擎。

空间索引:空间索引用于存储和查询具有空间坐标的数据,例如地理位置信息。它可以加速空间查询,例如计算距离、查找范围内的对象等。MySQL提供了多种空间索引类型,如R-Tree索引和Quadtree索引。

除了上述常见的索引类型,MySQL还支持一些特殊的索引类型,如前缀索引、多列索引、唯一索引、组合索引等。这些索引类型可以根据具体的需求和查询模式进行选择和创建,以提高查询效率和优化数据库性能。在设计和使用索引时,需要根据具体应用场景、数据量和查询需求进行权衡和综合考虑。
11. 主键和外键的区别?
主键(Primary Key)和外键(Foreign Key)是关系型数据库中的两个重要概念,它们有以下区别:

定义范围:主键用于唯一标识表中的每一行数据,并确保每行数据都具有唯一性,不存在重复。一个表只能有一个主键。外键用于建立表与表之间的关联关系,通过引用其他表的主键,在多个表之间建立起关系。

唯一性约束:主键必须保证每行数据的唯一性,不允许为空(null),且在整个表中唯一。外键则是对其他表的主键进行引用,可以允许为空值(null),但如果设置了外键约束,则必须引用其他表中已存在的主键值。

数据类型:主键通常使用整型数据类型,如INT或BIGINT,但也可以是其他数据类型。外键的数据类型必须与所引用的主键的数据类型相匹配。

表关系:主键是用来在同一张表中唯一标识每一行数据的,它与其他表没有直接的关系。外键则是用来建立表与表之间的关联关系的,通过外键约束,可以实现数据完整性的维护、数据关系的建立和查询的优化。

约束操作:主键支持自动递增(Auto Increment),即在插入新数据时自动生成唯一的主键值。外键可以设置级联操作,如级联更新和级联删除。级联更新是指当被引用的主键值发生变化时,自动更新外键值。级联删除是指当被引用的主键值被删除时,自动删除对应的外键值。

总之,主键用于标识表中每一行数据的唯一性,而外键用于建立表与表之间的关联关系,并通过引用其他表的主键来维持数据完整性和关系的一致性。主键和外键在数据库设计中扮演着不同的角色,但它们之间存在一定的关联和依赖关系,通常一起使用以构建复杂的数据模型和关系模式。
12. 查询计划
执行计划包含以下信息:

查询优化器选择的访问方法:MySQL的查询优化器根据查询条件、索引统计信息和表结构等因素,选择最优的访问方法。例如,使用全表扫描、索引扫描、范围扫描等方式来获取数据。

使用的索引信息:执行计划会显示是否使用了索引以及具体使用了哪些索引。索引能够加速查询操作,并减少磁盘IO开销。

表之间的关联关系:如果查询语句涉及到多个表,执行计划会显示表之间的连接方式,如使用嵌套循环连接(Nested Loop Join)、哈希连接(Hash Join)或排序合并连接(Sort Merge Join)等。

操作的顺序和方式:执行计划会显示操作的顺序,包括表的读取顺序、连接的执行顺序等。此外,还可以看到是否使用了临时表(Temporary Table)、文件排序(File Sort)等操作。

数据读取和过滤条件:执行计划会显示具体的数据读取方式,包括全表扫描还是索引扫描,以及过滤条件的应用情况。

统计信息和成本估算:执行计划会显示查询语句在执行过程中的成本估算,包括扫描行数、读取页数、排序操作的估算成本等。这些统计信息可以帮助开发者评估查询性能,并进行性能优化。

通过查看执行计划,可以了解MySQL是如何执行查询语句的,从而进行性能分析和优化。可以使用EXPLAIN关键字来生成执行计划,例如:

EXPLAIN SELECT * FROM table_name WHERE condition;
执行计划会以表格形式展示,列出各个步骤的详细信息。开发者可以根据执行计划来判断查询是否有效利用了索引、是否存在性能瓶颈,并针对性地进行调整和优化。
13. 覆盖索引
在MySQL中,覆盖索引可以通过以下几个步骤来实现:

创建合适的索引:首先,你需要创建一个合适的索引,以便能够支持要覆盖的查询。通常情况下,你需要创建一个包含查询条件和要返回的列的复合索引。这样,索引就可以满足查询条件并返回需要的列,而无需进一步访问数据页。
例如,如果你有一个查询语句如下:

SELECT column1, column2 FROM table WHERE column3 = 'value';
你可以创建一个覆盖索引来支持该查询:

CREATE INDEX idx_covering ON table (column3, column1, column2);
查询优化器的选择:当执行查询时,MySQL的查询优化器将根据索引统计信息和查询成本来选择最佳的执行计划。如果查询优化器认为使用覆盖索引的成本更低,它将选择使用覆盖索引来执行查询。

执行查询:如果查询优化器选择使用覆盖索引,它将直接使用索引来满足查询条件,并返回所需的列。这将减少了额外的磁盘I/O操作,提高了查询性能。

需要注意的是,覆盖索引并不适用于所有类型的查询。它主要适用于那些只需要返回少量列的查询。如果查询需要返回大量的列或涉及到大量的数据页,则使用覆盖索引可能并不能带来性能提升。

另外,尽管覆盖索引可以减少磁盘I/O操作,但它可能会增加索引的大小。因此,在创建覆盖索引时,你需要权衡查询性能和存储空间的利弊。

总结起来,覆盖索引是一种优化技术,通过在索引中包含查询所需的所有列,减少磁盘I/O和提高查询性能。在使用覆盖索引时,你需要创建合适的索引,并确保查询优化器选择使用覆盖索引执行查询。
脏读
不可重复读取
同一个事务内的第一次查询, 和第二次查询结果不一样
幻影读
通常是针对整张表